Ontology Harmonizer
Ein Forschungsprototyp, mit dem sich Feldbezeichnungen aus Forschungsdaten einheitlichen Ontologiebegriffen zuordnen lassen. Einmal erstellte Zuordnungen sollen für weitere Forschungsdatencontainer mit derselben Struktur wiederverwendet werden können.
Projekt auf GitHub ansehen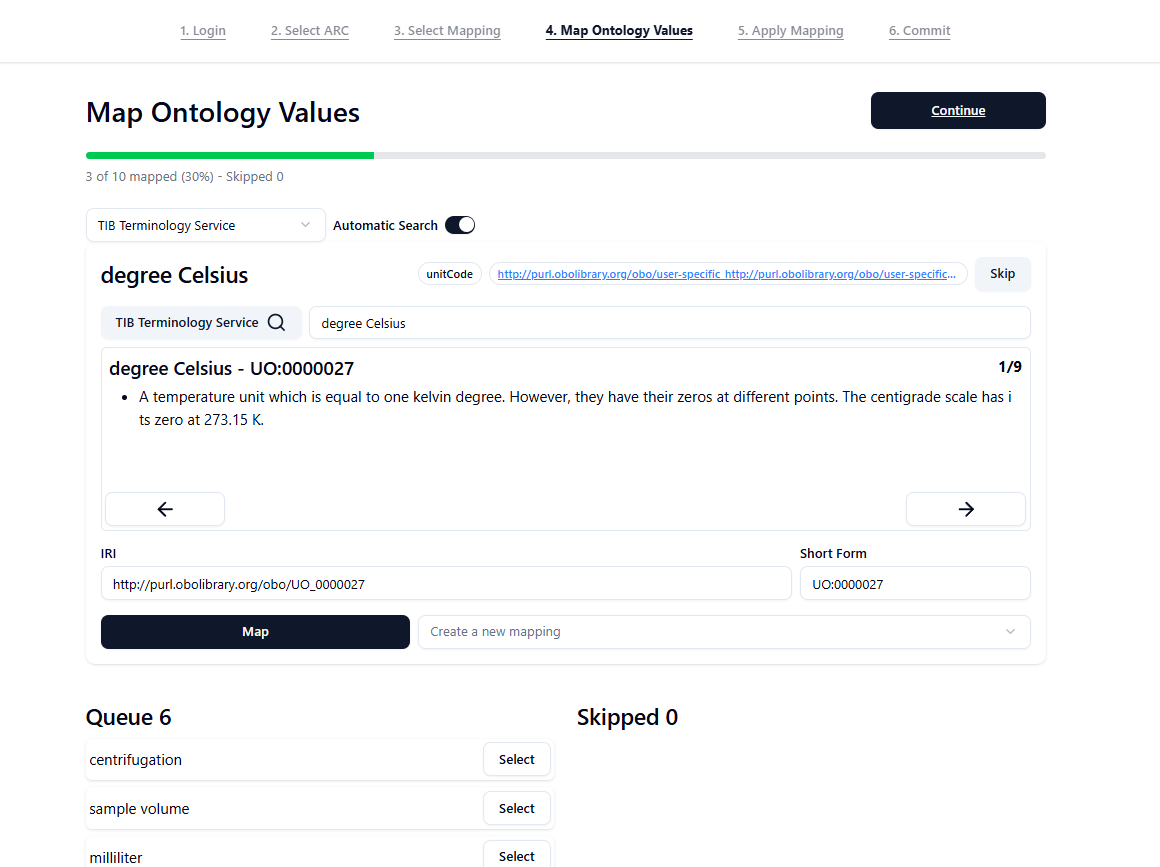
Ausgangslage
Datenbanken verwenden oft einfache oder abgekürzte Feldbezeichnungen. Werden ihre Inhalte in Forschungsdatencontainer, sogenannte ARCs, überführt, sollen diese Bezeichnungen mit standardisierten Ontologiebegriffen verknüpft werden.
Für Datenbanken mit gleichbleibender Struktur sollte diese Zuordnung nicht jedes Mal neu entstehen. Ziel war deshalb ein Mapping, das einmal fachlich erstellt und anschließend auf weitere ARCs derselben Forschungsdateninfrastruktur angewendet werden kann.
Umsetzung
Ich habe eine Webanwendung entwickelt, die durch das Erstellen dieser Zuordnungen führt. Nutzer laden einen ARC, suchen passende Ontologiebegriffe und speichern ihre Auswahl als wiederverwendbares Mapping. Dieses lässt sich auf die geladenen Metadaten anwenden und zusammen mit den überarbeiteten Daten exportieren.
In meiner Bachelorarbeit habe ich außerdem untersucht, wie unterschiedliche Suchverfahren passende Begriffe vorschlagen: über externe Terminologiedienste, lexikalische Vergleiche und eine vektorbasierte Suche. Die Vektorsuche lässt sich als optionaler Dienst in die Anwendung einbinden. Die fachliche Auswahl bleibt beim Nutzer.
Ergebnis
Der Mapping-Workflow wurde als Prototyp umgesetzt. Aus den beteiligten Forschungsdateninfrastrukturen und Datenbanken lagen noch keine für uns nutzbaren ARCs vor. Für die Tests arbeiteten wir deshalb mit selbst zusammengestellten Beispieldaten. Ein Test mit den vorgesehenen ARCs aus dem Forschungsbetrieb steht noch aus.
Für die Untersuchung der Suchverfahren nutzte ich unter anderem eine Ground Truth mit praxisnahen Feldbezeichnungen und Abkürzungen, für die passende Zielbegriffe festgelegt waren.
Aktuell entwickle ich das Tool mit dem standardisierten Mapping-Datenmodell SSSOM weiter. Eine gemeinsame wissenschaftliche Veröffentlichung ist ebenfalls im Gespräch.
Rückblick
Die untersuchten Vektorverfahren lieferten bei fachlich eindeutigen Bezeichnern gute Vorschläge und kamen an die Ergebnisse rein lexikalischer Vergleiche heran. Bei manchen kryptischen oder ungewöhnlichen Bezeichnern zeigten sich zusätzliche Vorteile. Wegen des kleinen Datensatzes sind das jedoch Hinweise, die genauer untersucht werden müssen.
Eine weiterführende Frage ist, wie zusätzlicher Kontext die Zuordnung verbessern könnte. Ein Feldname wie origcty ist für sich genommen schwer verständlich. Steht darin beispielsweise der Wert Germany, liefert das einen Hinweis darauf, dass ein Herkunftsland gemeint sein könnte. Die Suche könnte also neben dem Feldnamen auch die enthaltenen Werte berücksichtigen. Das habe ich in der Arbeit nicht mehr untersucht – aus den Ergebnissen entstand damit die nächste Forschungsfrage.